热搜关键词: 老化板定制 BGA测试座 芯片老化板 IC测试座定制
创新型 专精特新企业
 订购热线:13632719880
 订购热线:13632719880
一颗 H100 级别的 GPU 贴上测试头之后,接下来发生的事情有严格次序。先是毫秒级的开短路筛查,然后才是 DC 参数、Scan、高速 SerDes 训练和功能向量。这个顺序不是习惯,是成本核算的结果:一颗大面积 GPU 的完整 Scan 加高速接口训练要占掉几十秒机时,而高端 SoC 测试机的小时成本在数千元量级。让一颗 BGA 锡球已经断开的芯片去跑链路均衡训练,等于把最贵的资源花在最快该被报废的样品上。
导通测试(Open-Short,也称 Continuity Test、Contact Test)就是这道闸门。它的任务是低成本、无损伤地
确认两件事:所有信号引脚确实与外界建立了电气连接;这些引脚之间没有出现不该有的低阻通路。放在最前面,因为它快、便宜,而且能在第一时间暴露一类特殊问题——包括测试座自己的问题。
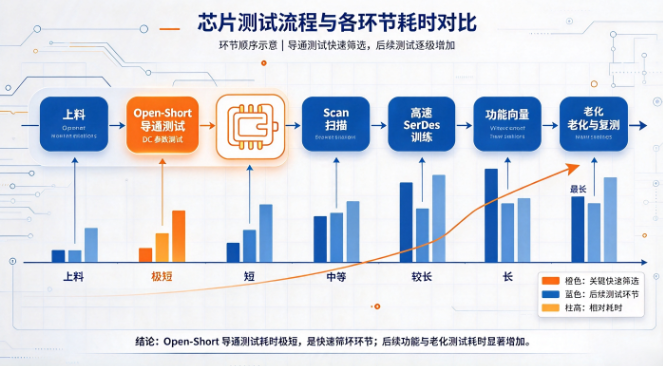
典型的 FT 流程是这个次序:
OS 在其中承担的是筛查(screening)而非验证(verification)。它不问这颗芯片性能如何,只问这颗芯片值不值得继续往下测。
它需要挡住的失效大致五类:BGA 锡球开路(含枕头效应、不润湿开路、焊盘剥离)、锡球桥接短路 、键合线缺失或搭接、Die 级早期击穿 (栅氧击穿、介质层短路),以及最常被忽略的第五类——测试座的假性接触不良。
第五类值得单独说,因为 OS 是整个流程里唯一能实时提示"是器件坏了还是夹具坏了"的环节。每一次挂牌的 OS 失效,都应该先问一遍这个问题,而不是直接判死。
对 GPU 而言 OS 的性价比尤其高:它是单位时间覆盖物理量最多的一项测试,一次并行测量走完,几千枚锡球的物理完整性就有了结论。这也是为什么即便 OS 的覆盖率有限(第八章会讲边界),各家产线依然雷打不动地把它放在第一位。
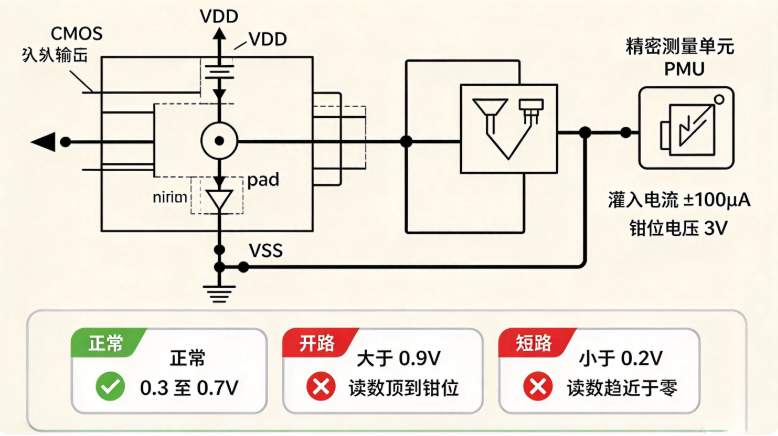
OS 能做无损筛查,靠的是芯片自带的资源——IO pad 上的 ESD 保护二极管。标准 CMOS IO 在 pad 与 VDD 之间、pad 与 VSS 之间各有一个保护二极管或等效保护结构,正常工作时它们全部反向截止。OS 借用的正是这两条原本闲置的通路。
标准做法是"加流测压":
1. 先把器件所有引脚(含全部电源与地)拉到 0V;
1. 用 PMU 向被测引脚灌入恒定小电流,通常 ±100µA,部分引脚类型会用到 100~500µA;
1. 测量该引脚的电压;
1. 必须设定钳位电压(常见 3V),否则开路引脚上的电压会一路攀升,把器件和测试机通道一起打穿。
读数判读逻辑很朴素:
|
状态 |
对 VDD 侧(+100µA) |
对 VSS 侧(-100µA) |
物理含义 |
|
正常 |
0.3 ~ 0.7V |
-0.3 ~ -0.7V |
二极管正常正向导通,读数即 PN 结正向压降 |
|
开路 |
大于 0.9V(部分规格放宽到 1.5V ) |
小于 -0.9V |
无电流通路,读数直逼钳位值 |
|
短路 |
小于 0.2V |
大于 -0.2V |
存在低阻旁路,电流被分流 |
真正决定成败的是表之外的几条经验。
并行测量有盲区。 现代测试机普遍是 Per-Pin PMU 结构,为了压缩测试时间,工程上的做法是让所有通道同时灌电流、同时测。但这样一来,如果两个相邻引脚之间存在低阻短路,它们会被同一节点拉到等电位,各自的读数仍然落在窗口内——引脚间的短路在并行模式下是测不出来的 。补这个洞的办法有三种:串行逐一测量(准确但慢)、上电后跑功能验证做二次把关、或者采用分组拉低的改进步序。选哪一种,本质是拿测试时间去换覆盖率。
电源脚不能这么测。 VDD、VSS 铺的是整片低阻网络,本身的阻抗低到让加流测压失去分辨率。电源引脚通常另走一路方案:给 VDD 施加 0.3V 低电压,钳位设在 ±2mA,测量该脚电流是否落在 ±100µA 量级的规定范围内。
窗口不能一刀切。 0.3~0.7V 这个经验值适用于普通数字 IO。而 GPU 上带着差分 SerDes 引脚(带片上终端与耦合结构)、PLL 的模拟电源输入、带上下拉配置的 GPIO、以及熔丝与一次性编程引脚——这些结构的响应各不相同,读数会有明显偏移,有些甚至不能按标准 OS 处理。正确做法是按引脚类型分组设定窗口 ,用已知良好的样片实测出基准值,而不是全器件套同一套规格。对熔丝类引脚,不少方案会直接跳过标准 OS,改由后续专项流程覆盖,避免误伤。
如果只能挑一个 GPU 导通测试的技术难点,那就是多电源域。
一颗数据中心级 GPU 内部通常划着十几个到几十个电源域:核心计算域、多个 HBM 相关域(对应堆栈所需的 VDDQ、VDDC、VPP 等)、IO 域、PCIe 模拟域、PLL 与常开域、熔丝编程域……每个域都有独立的供电要求,也挂着自己的静电保护网络。这带来四个层面的麻烦。
其一,跨域短路会被标准算法掩盖。 OS 第一步是把所有引脚接地,这一步把所有 IO 的保护二极管上端连到了同一个电位点。如果两个本该完全独立的电源域之间发生了短路,在这个状态下它们本来就是等电位的,缺陷无法被分辨 。也就是说,全域接地法对跨域缺陷是盲的。要检出这一整类问题,需要额外的轨到轨隔离测试:把所有电源域浮接,再两两之间施加激励、测量响应,判断是否存在不该有的通路。这项测试的时间成本不低,但在跨域短路的危害面前是值得的——这类缺陷一旦流到下游,表现形式往往是上电即损毁整个模块。
其二,芯片内部有意的钳位结构。 为了让静电泄放电流有通路,相邻电源轨之间会布置 RC 触发大尺寸 clamp 一类的保护器件。这些结构的响应是非线性的,读数不再是干净的 0.7V,按标准窗口判会出现大量莫名其妙的失效。这类行为没有通用答案,只能靠与已知良好样片的长期对照来消化。
其三,域间的保持开关。 部分域之间会通过电平转换或保持寄存器相连,在未上电状态下可能通过体二极管天然连通。这意味着并非所有域对都适合做两两判定 ,有些组合在物理上就是"应当连通"的。这需要和设计端逐域确认,把"允许连通"与"必须隔离"的清单维护起来。
其四,隐藏短路与极低阻平面。 GPU 的电源与地引脚数量往往以千计,整片铺开后构成极低阻抗的平面。在这种平面上,一个几十欧姆级别的电源到地软短路,在 100µA 激励下只产生约 1mV 的偏移——完全湮没在噪声里 。而这颗十欧姆级别的异常通路,很可能在上电后酿成灾难。这类缺陷 OS 抓不到,必须靠上电后的静态电流监测与电源轨监测来补位,这是第八章边界问题的核心样本。
最后还有时间成本:大面积芯片的电源网格电容可观,每次激励后需要足够的稳定时间读数才可靠,这在并行测试中会直接转嫁为测试时间。
这是 GPU 导通测试最需要说清楚的一件事,很多人的理解在这里是错的。
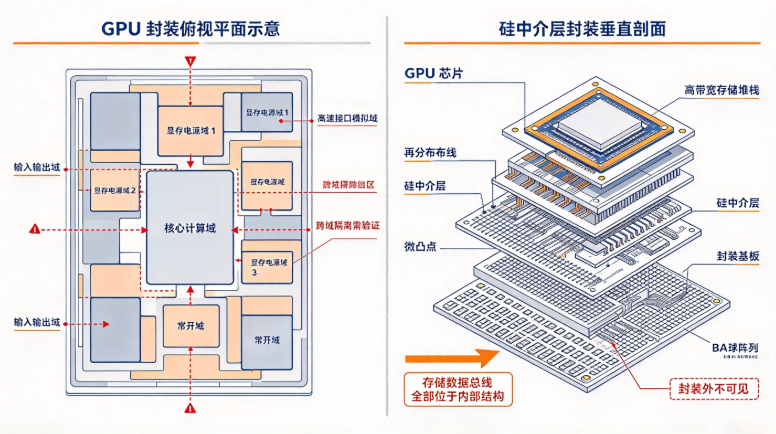
HBM 走的是硅中介层互连,不是常规的封装扇出。 GPU 芯片与 HBM 堆栈并排坐在中介层上,两者之间的数据、地址、时钟通路全部藏在中介层的再分布布线与微凸点之间。单个 HBM 堆栈对外是 1024 位接口宽度(16 个通道、每通道 64 位),一颗 GPU 挂 5 到 6 个堆栈,总线宽度落在数千位量级——但这些信号引脚在封装外一个都看不到 。
由此得到一个不太容易接受的结论:FT 阶段针对 HBM 接口的导通测试,覆盖范围远小于直觉。 能被触达的只有三类:
1. HBM 相关电源轨的连通性与域间隔离;
1. 少量被引出到封装外的 HBM 控制、复位、参考类引脚(前提是产品做了这样的引出);
1. 通过 JTAG 或 IJTAG 访问 PHY 内部寄存器与测试结构,做结构化的完整性检查。
真正的 HBM 互连筛查其实已经前置了:在封装前的中介层测试环节,需要对每一个微凸点做连续性验证、对硅通孔做通路筛选,先确认堆栈本身是良好的再去贴合。如果这一步没做扎实,缺陷会带着封装流程一路走到 FT,而此时 OS 已经抓不到它。
对比消费级就很清楚。高端显卡用 GDDR 系列显存,这些是常规扇出到 BGA 锡球的,数据、命令、地址、时钟都有物理引脚可测 ,OS 可以直接覆盖。区别只是这时挑战换成了另一件事:显存接口的球间距密、相邻球数量庞大,检测重点从"能否测到"变成了"能否分辨紧邻球的微短路" ——这对针尖定位精度与共面度一致性是完全不同的要求。
两条路线因此分得很开:采用 HBM 的算力卡是"能测的量少了,对每个域的精度要求高了";采用 GDDR 的消费卡是"全部能测,但对高密度相邻球的分辨能力要求极高"。 这两类产品在治具方案上几乎不能通用。
边界扫描(IEEE 1149.1,配套的仪器访问是 IEEE 1687)常被人当作 OS 的替代方案,更准确的定位是互补。
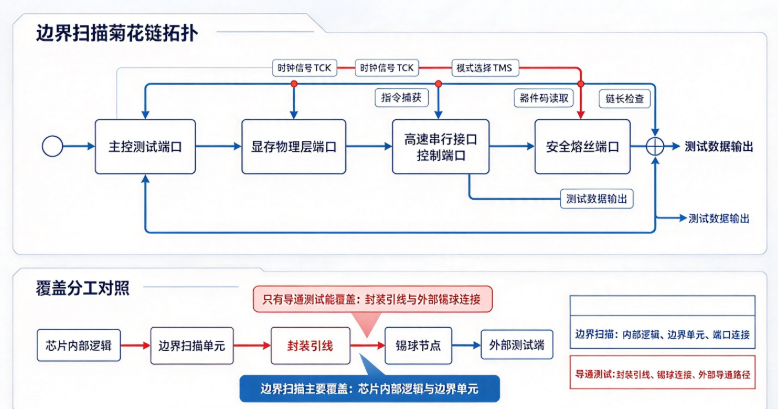
标准的链路完整性验证流程是:复位测试访问端口,做指令寄存器捕获,正常的端口应回访到规定的图样;读取器件标识码确认型号与版本;再检查数据寄存器链的长度是否与预期一致。GPU 上通常不止一个测试访问端口,主控制端口、各 HBM 的物理层端口、SerDes 控制端口、安全与熔丝端口会串成一条完整的菊花链,任何一环节断开,后面的都表现为读不到。
关键在分工边界。 边界扫描单元位于 pad 的内侧,这意味着 pad 到 BGA 锡球这一段物理路径上的断线——恰恰是枕头效应、焊点开裂、助焊剂残留发生的地方——边界扫描完全抓不到 ,这一段只能靠 OS 守。反过来,OS 依赖每个 pad 上存在可用的保护二极管,遇到纯模拟 pad、带特殊终端的差分引脚、熔丝引脚就可能失效或读数不可靠,而这些地方边界扫描或后续的环回训练反而能覆盖。
还有一条容易忽略的顺序约束:边界扫描需要上电才能跑,OS 在不上电状态下就能完成。 这个差异决定了二者物理上不可能对调——先由 OS 确认没有硬缺陷,再上电跑扫描,是唯一合理的次序。让一颗存在电源到地短路的芯片上电去跑边界扫描,代价无法接受。
高端 GPU 是少数仍被要求做长时间动态老化的器件,行业标准普遍在单次一千小时以上量级,而且通常是动态老化——芯片在老化座里持续跑测试图样,不是单纯烘烤。
成熟的流程一定会做三件事。
第一,建基线。 老化前的导通数据按颗存档,作为该器件的个体基线。
第二,测差值。 老化结束、冷却到规定温度后重跑同一套向量,与老化前的数据逐引脚比对。真正有信息量的是差值而不是绝对值:某个锡球的读数从 0.62V 漂到 0.71V,和它直接顶到 3V 钳位,是两个完全不同的故事。
第三,严控测量条件一致。 同一个灌入电流、同样的等待时间、同样的接壳温度,任何一项变了,差值就失去意义。这条纪律看似基础,实际在换线、换季、临时调换治具的时候最容易破功。
老化后新出现的导通失效,归属判断分两类。
流向真实失效的,常见的是电迁移引发的空洞、铜柱与焊料界面金属间化合物持续生长形成的空洞、微凸点与硅通孔的热疲劳,以及封装应力在热循环后把原本若即若离的焊点彻底分开。这一类确实该被筛掉。
流向假性失效的,几乎全部与治具有关:老化座针尖在高温下的氧化、助焊剂残留高温碳化堆积、以及大尺寸封装在热态下翘曲形态改变造成的局部接触失效。这类会把良品判死,是最不该出现却最常见的损失。
区分手段只有一条可靠路径:换一个已知良好的黄金治具复测,辅以 X 光或超声波扫描的物理确认。任何只基于统计、不做实物复核的判罚都值得怀疑。
这里还有个常被忽略的反向用法:老化前后的导通差值数据,其实是校准治具状态的最好原料。 某个工位的差值分布开始整体右移,往往说明该工位治具的接触寿命到了,这比按固定插拔次数强制更换要准得多。
把导通失效的归因做清楚,是量产里最省钱的一项工程活。
器件侧的真实缺陷,典型的名单是:锡球开路(枕头效应、不润湿、焊盘裂纹)、锡球桥接、键合线缺失或塌丝、静电损伤(表现为正向压降非对称漂移并伴随漏电上升)、中介层再分布层开路、以及栅氧击穿一类的芯片级缺陷。这类失效的特征是可重复、与工位无关、失效位置与物理形态相关。
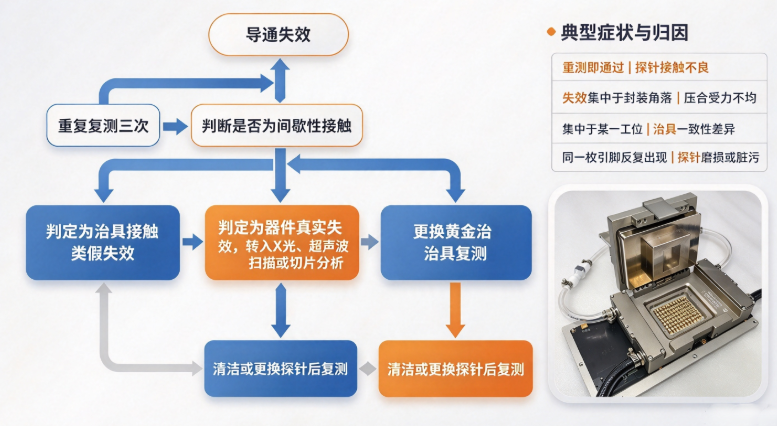
治具侧的假性失效,症状差异明显:
重测即通过——九成以上指向间歇性接触失效,根源通常是针尖污染或弹力衰减;
失效集中在封装的角落或某一边——指向大封装翘曲与治具共面度不匹配;
失效集中在某一个工位——指向机械手压合机构或该工位治具本身;
同一枚引脚反复排在前几位——这根探针大概率坏了、脏了或者丢了。
这里有一个普遍的误解值得纠正。OS 是加流测压,接触回路里串联的几十到上百毫欧电阻,相对 0.7V 的二极管正向压降完全可以忽略 ——100µA 电流下,100mΩ 只贡献 10µV。所以 OS 对治具的真实要求并不是"接触电阻做到多低",而是"每一次都确定性地接触到"。这个结论直接影响选型:几何一致性、压力均匀性、抗间歇失效的能力,比锱铢必较的毫欧指标重要得多。
顺带建议一条标准排查动线:同一治具立即复测三次 → 更换黄金治具复测 → 清洁或更换探针后复测 → 用已知良品校验工位 → 统计失效引脚的地理分布与工位分布 → 必要时做 X 光、超声波扫描或切片。 前两步成本几乎为零,却能拦下绝大部分非器件失效。
讲了这么多能力,更要讲清楚它不是什么。
OS 抓不到高阻软缺陷。 一个几百千欧级别的漏电通路、一对之间有高阻介质的相邻锡球,在 100µA 激励下都安静地躺在窗口里。这与第三章讲的极低阻平面上的隐藏短路是同一类问题的一体两面:OS 的动态范围决定了它只能识别"通"与"断"两个极端。补这个洞靠的是输入漏电测试与静态电流监测——OS 负责硬缺陷,漏电类测试负责软缺陷,两者是固定搭档,不是一个覆盖另一个。
OS 抓不到潜在开路。 一颗处于若即若离状态的焊点,常温下可能仍有足够通路让读数落在窗口内,只有在高温、振动或长期通电后才会彻底分离。这也解释了为什么老化环节不能被任何静态测试取代。
OS 不提供任何功能覆盖。 导通通过,不代表这枚引脚跑得动高速链路训练,更不代表内部逻辑正常。它只确认物理上通着。把导通通过率当成某种质量指标是危险的。
OS 本身也有损伤风险。 钳位电压、灌入电流、特殊引脚的处理方式都需要按引脚类型分级设定。熔丝类引脚、部分模拟输入引脚如果套用标准 IO 的激励条件,是可能造成实际损伤的——这与开篇"无损伤筛查"的目标直接冲突。
最后是时间。 大面积芯片的电源网格电容让等待时间不可忽略,加上为检出引脚间短路所需的补充环节,导通测试的机时占用不再天然免费。在一颗测试成本以分钟计的器件上,收益与时间的再平衡是持续存在的课题。
把前面七章的痛点收拢,会发现 GPU 导通测试的失败里,真正能被治具消化的集中在三件事:几何一致性、宽温下的长期接触稳定性、大球数大封装的适配能力。
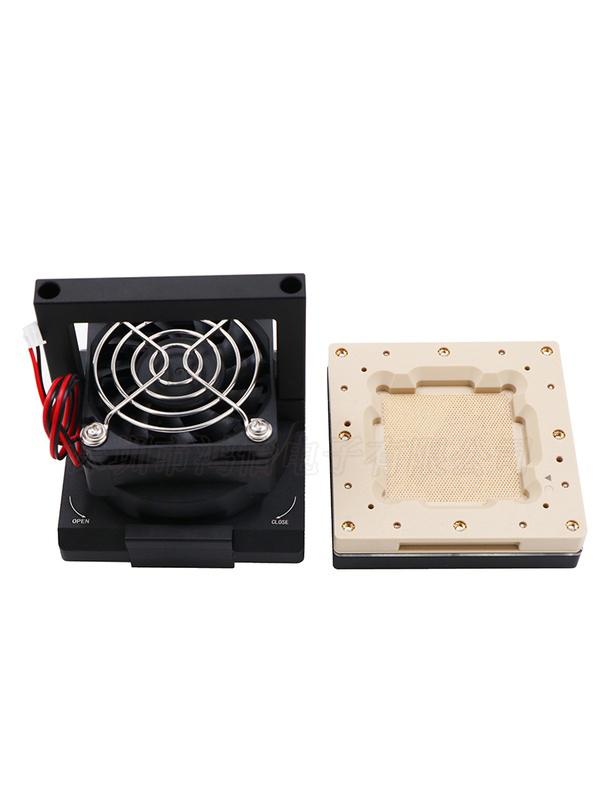
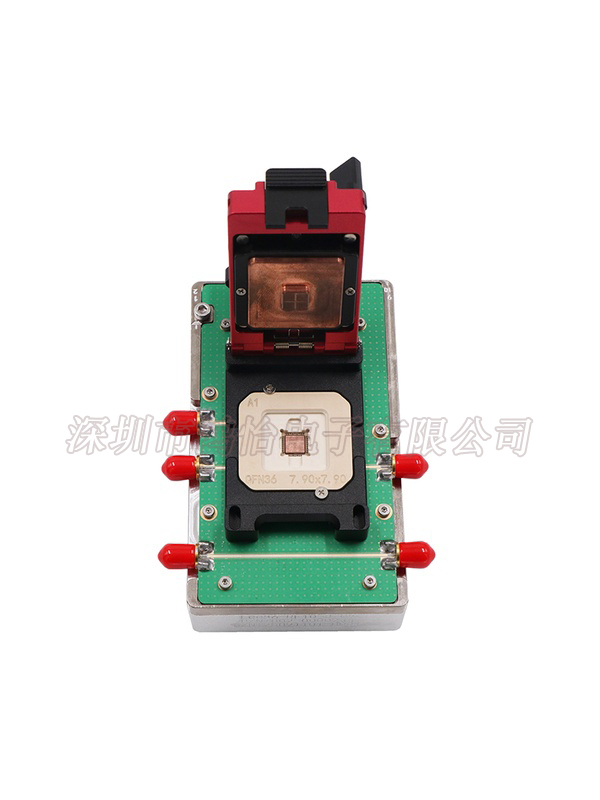
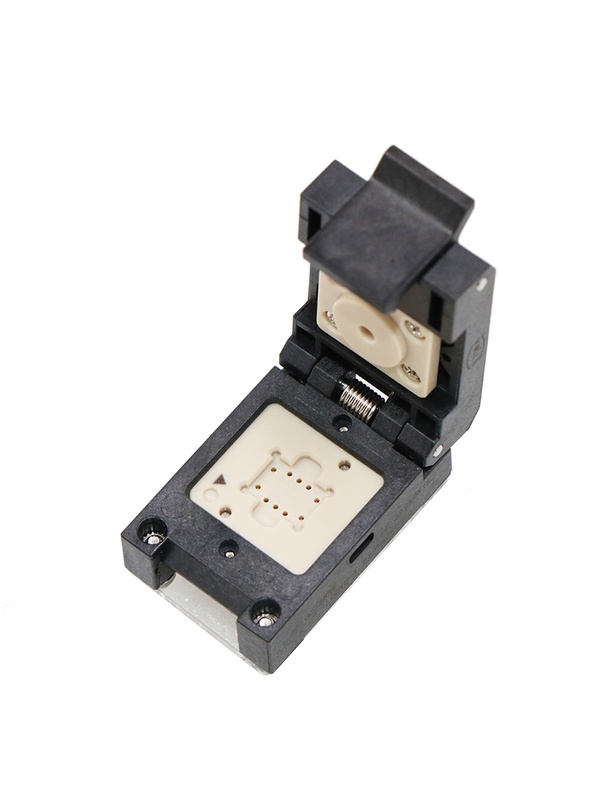
深圳市鸿怡电子(HMILU)在这一块是围绕 GPU 全流程布线的:GPU 芯片测试治具、专用老化座、DDR 与显存类夹球测试座、对接主流测试机的自动化测试座 ,覆盖消费旗舰与数据中心算力卡这一类封装,从 BGA456 级别的显卡芯片测试架一路做到 BGA1024(33×33mm、1.0mm 间距)级别的合金双扣旋钮探针座,更大球数与特殊结构走开模定制。三条产线(现货标准品、加工定制品、开模定制品)的配置,本质上是为了适配 GPU 领域标准品难以满足、非标需求密集的现实。
对照前面的章节,几项公开规格的落点如下。
几何一致性,对应第七章的位置型假失败。 鸿怡的 GPU 测试治具采用高刚性铝合金框架加精密定位结构,公开给出的整机定位误差在 ±0.01mm 以内;显存类夹球测试座以弹性夹压加精准对位的结构,把夹球接触压力的均匀性误差控制在 ±5% 以内。这两项服务的是失真度最高的那两类情形:大封装翘曲下角落锡球接触不到,以及并行作业时不同工位之间的接触差异。这正是导通假失败最主要的两个来源,也是治具唯一能直接消化的部分。
宽温长期稳定性,对应第六章的老化前后差值。 GPU 老化座选用铍铜并经热处理的接触探针、配多层镀金,公开规格给出的初始接触阻抗在 5mΩ 以内;基座采用耐高温改性陶瓷,热膨胀系数标称 6.0ppm/℃,125℃ 环境下的形变率标称小于 0.02%,以满足单次一千小时以上的长时老化需求。需要说明的是,导通测试本身对绝对接触电阻并不敏感(第七章已述),这类规格的真实价值不在数字大小,而在经历宽温循环之后接触力还在不在、插拔之间的波动是否可控 ——决定老化前后差值可信度的正是后者。
低串扰与大电流承载,对应第三章的电源域问题。 治具内部按分区屏蔽设计,通过金属屏蔽罩与接地网络的布局抑制临近通道串扰;供电侧采用大截面铜箔线路配合耐高温绝缘材料,公开给出的单路电流承载能力在 10A 以上。对动辄几十路电源、单路电流可能上十安培的器件来说,供电通路的压降与寄生参数会直接影响低阻抗条件下的测量分辨率——第三章讲的隐藏短路检出难点,有一部分根子就在这里。
此外,可维护性也要计入导通测试的总成本模型。探针支持单独更换这一设计(鸿怡各系列的通行做法)的意义在于:一次针尖污染不必更换整只治具,对第四、七章讨论的单点污染导致持续假失败的情形,这是成本最优解。
回过头看,GPU 导通测试的技术含量不在它有多复杂——加流测压本身极其朴素——而在于边界的把握 :哪些缺陷它必然抓得住(锡球开短路、键合缺失、测试座子的间歇失接触),哪些它天然抓不到(高阻软短、潜在开路、中介层内部通路),以及用后续的漏电测试、边界扫描、老化复测去精确补位。
把这道第一关的位置、能力边界和配套设施都想清楚,后面的 DC、Scan、高速接口才会顺——毕竟那才是真正花钱的环节。
【本文标签】 鸿怡电子GPU芯片导通测试夹具 Open-Short测试 GPU芯片测试治具 显卡芯片测试夹具 GPU测试座
【责任编辑】
GPU导通测试的技术含量不在它有多复杂——加流测压本身极其朴... 【详情+】
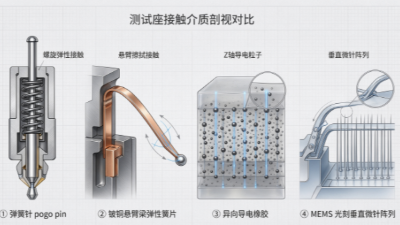
IC测试座的选型,本质上是在"封装几何—电气性能—环境应力—... 【详情+】

 传真:0755-23287415
 电话:13632719880 0755-83587595
 邮箱:liu@hydz999.com
 地址:深圳市宝安区西乡大道288号宝源华丰总部经济大厦A座1108室
友情链接: 鸿怡电子测试座socket商城
深圳市鸿怡电子有限公司 保留一切权利 备案号:粤ICP备16068982号 百度统计